Desarrollo webInfraestructuraProducción5 min de lectura
Publicado el 13 oct 2026 · Por Mario J, Core Dynamics
Nunca había sido tan fácil crear una aplicación o una web. Las herramientas de programación con IA, los frameworks modernos y las plataformas alojadas permiten convertir una idea en una interfaz funcional en pocos días. Un prototipo que antes requería un equipo ahora puede salir del trabajo de una sola persona.
Eso desplaza el punto en el que empieza el trabajo difícil. Una demo demuestra que la idea se puede construir. No demuestra que los clientes puedan confiar en ella, que sus datos estén protegidos o que el negocio pueda sostenerla cuando aumente el uso.
La nueva brecha: crear software es más fácil; prepararlo para usuarios reales sigue requiriendo ingeniería.
Un prototipo responde a «¿funciona esta idea?». El software en producción debe responder cada día a preguntas más exigentes: ¿pueden iniciar sesión las personas de forma segura?, ¿se recupera el sistema si falla una dependencia?, ¿puede el equipo encontrar la causa de una petición lenta?, ¿se pueden publicar cambios sin interrumpir el servicio?
Estas preguntas suelen aparecer cuando la primera versión ya tiene usuarios. Puede que no haya copias de seguridad fiables, que los permisos no estén claros, que los despliegues sean frágiles, que falten alertas o que la base de datos nunca se diseñara para tráfico real. Corregirlo todo después puede costar más que preparar esos cimientos antes del lanzamiento.
Da igual si la primera versión la escribió un equipo experimentado, la generó una IA, se montó con una herramienta no-code o la entregó una agencia. La herramienta de construcción no elimina la necesidad de operar el producto.
Qué significa estar listo para producción
La preparación para producción no consiste en pulsar un botón de despliegue. Es un conjunto de prácticas que permite cambiar el software con seguridad y ofrecer un servicio fiable:
Ingeniería de aplicaciones fiable: arquitectura clara, código mantenible, pruebas automatizadas útiles y gestión correcta de errores y casos límite.
Seguridad y protección de datos: autenticación adecuada, controles de acceso, secretos protegidos, dependencias actualizadas y tratamiento cuidadoso de datos personales.
Infraestructura operativa: entornos reproducibles, despliegues automatizados, copias de seguridad, monitorización, alertas y un plan de recuperación.
Responsabilidad después del lanzamiento: documentación, responsabilidades claras y una forma práctica de responder a incidentes y mejorar el producto.
La preparación para producción combina pruebas de calidad, seguridad, monitorización y recuperación.
El nivel adecuado depende del producto. Una pequeña página pública no necesita los mismos controles que una plataforma de pagos. El objetivo es comprender los riesgos y aplicar las salvaguardas que correspondan.
Validación humana y mercados locales
La IA puede crear una interfaz convincente y superar las pruebas que le hayan pedido ejecutar. Eso no basta para saber si el producto tiene sentido para quienes lo van a utilizar. Usuarios reales y personas revisoras con experiencia deben validar el producto completo: los recorridos principales, los puntos confusos, la accesibilidad, la precisión y el tono de las respuestas de IA y lo que ocurre cuando el sistema duda o se equivoca.
La validación reúne a quienes construyen el producto con las personas que lo utilizarán.
En algunos contextos, la intervención humana también forma parte del diseño operativo. En la Unión Europea, el Reglamento de IA exige que los sistemas de alto riesgo se diseñen para permitir una supervisión efectiva por parte de personas. El RGPD también puede reconocer el derecho a obtener intervención humana en ciertos casos de decisiones basadas únicamente en tratamientos automatizados que tengan efectos jurídicos o similares. Las obligaciones dependen del sistema, de su finalidad y de las normas aplicables; no implican que todas las funciones de IA requieran el mismo proceso de revisión. Consulta el Reglamento europeo de IA, artículo 14, y el RGPD, artículo 22.
La supervisión debe funcionar en la práctica. Puede hacer falta definir puntos de aprobación, permitir que una persona cuestione o revoque una respuesta de IA, ofrecer explicaciones útiles, establecer vías de escalado y registrar lo ocurrido. Una política escrita no basta si quienes operan el sistema no entienden sus resultados o no pueden intervenir a tiempo.
El producto también debe sentirse natural en cada mercado. Localizar no es solo traducir textos: puede implicar adaptar el idioma y el tono, los formatos de fecha y números, los métodos de pago, la accesibilidad, la atención al cliente y los requisitos locales de producto o regulación. Un flujo obvio para un público puede resultar confuso para otro.
Core Dynamics ofrece validación integral de producto con revisión humana real, desde pruebas de recorridos completos hasta comprobaciones de respuestas de IA y operaciones, además de localización para distintos mercados. Ayudamos a adaptar la experiencia y los procesos de revisión a las personas usuarias y jurisdicciones a las que se dirige el producto.
Cómo cerrar la brecha
No siempre hace falta empezar de cero. Una revisión concreta permite identificar qué funciona, qué podría fallar con usuarios reales y qué cambios conviene hacer antes del lanzamiento. A partir de ahí, puede bastar con reforzar la aplicación actual, rehacer una función frágil o definir una infraestructura gestionada para el producto.
Core Dynamics ayuda a los equipos a cubrir esa brecha con tres servicios conectados: desarrollo web y de aplicaciones a medida para productos que necesitan mejores cimientos; diseño e integración de flujos de agentes de IA para automatizar procesos reales; e ingeniería de infraestructura para despliegues, monitorización, fiabilidad y operaciones continuas.
Partimos del software que ya tienes y del resultado que buscas. Después concretamos el camino hasta producción: qué debe cambiar, cómo comprobaremos el éxito y quién se responsabilizará del sistema cuando dependan de él usuarios reales.
El nuevo modelo de ingeniería: las personas dirigen, los agentes ejecutan
Ingeniería de IAFábricas de softwareModelo operativo10 min de lectura
Publicado el 20 sep 2026 · Por Adam C, Core Dynamics
Los agentes de programación con IA cambian algo más que la velocidad de implementación. Cuando un agente puede inspeccionar un repositorio, planificar un cambio, escribir código, ejecutar pruebas, responder a revisiones y preparar un lanzamiento, deja de ser útil asumir que el trabajo de ingeniería simplemente pasa de una persona a otra.
El recurso escaso ya no es la capacidad de producir otro borrador de código. Es definir el problema correcto, aportar contexto fiable, establecer límites de decisión, evaluar las pruebas y asumir la responsabilidad del resultado.
De ahí surge otro modelo operativo: las personas dirigen el sistema y responden de los resultados; los agentes ejecutan tareas acotadas y aportan evidencias. No se trata de eliminar al equipo de ingeniería, sino de crear una fábrica de software donde la autonomía sea deliberada, observable y reversible.
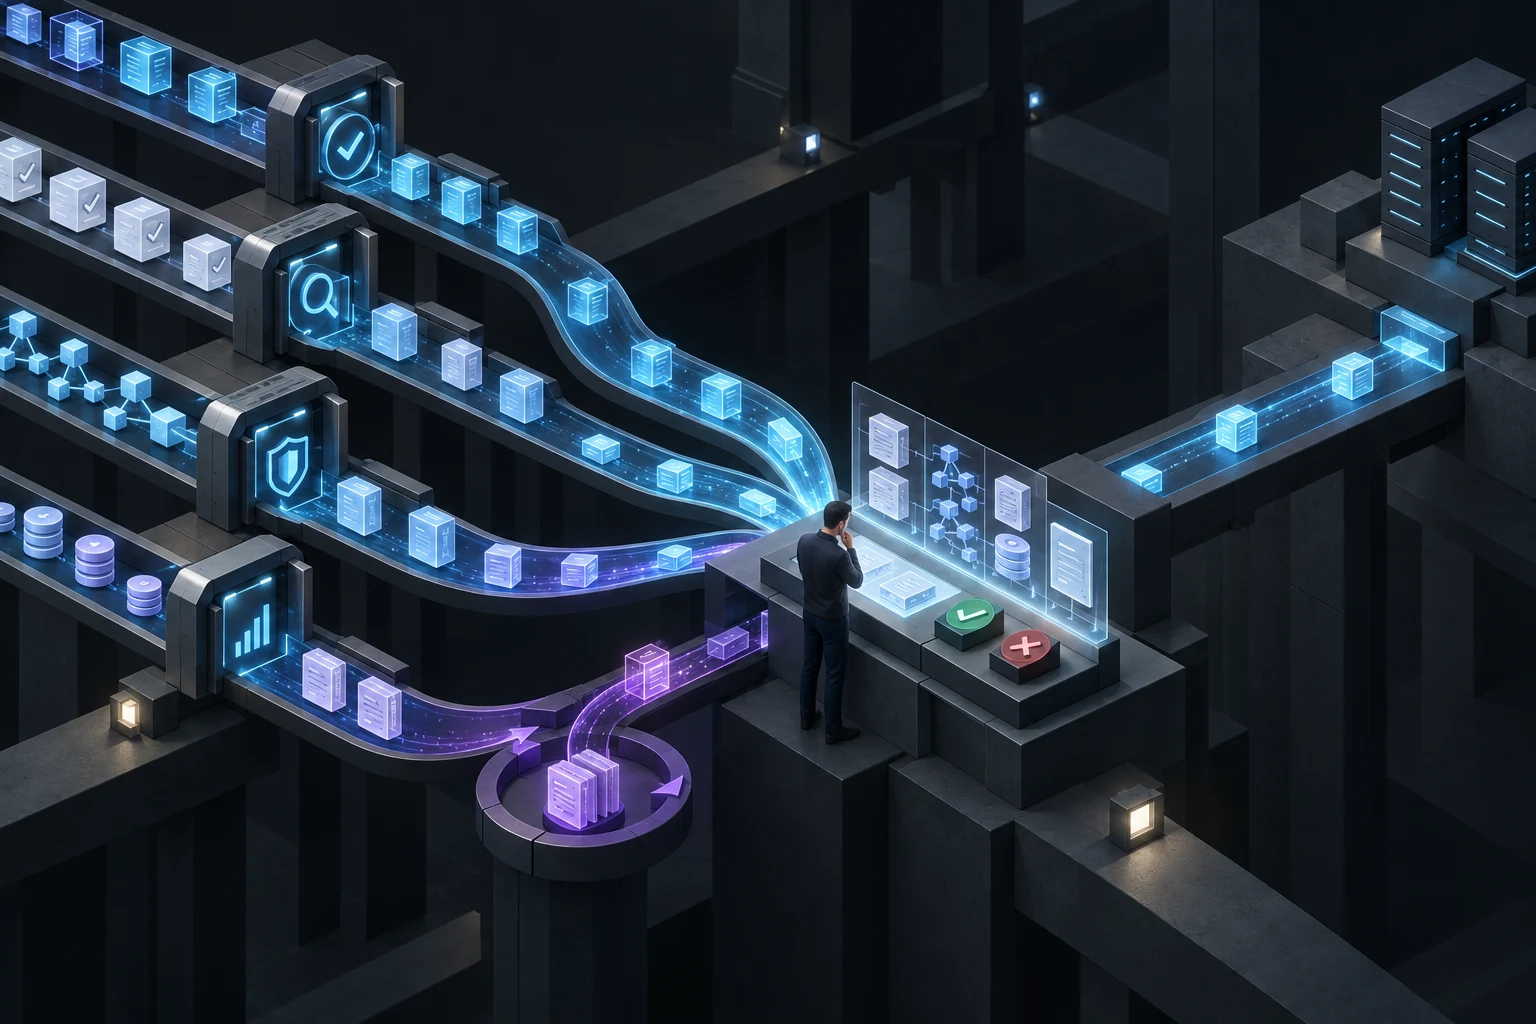
Las etapas de agentes especializados se conectan mediante una capa de orquestación común; el equipo define la intención, los límites, el contexto y las condiciones para publicar de forma segura.
Principio operativo: asigna a los agentes tareas bien definidas y reversibles. Mantén a las personas al frente de la intención, la arquitectura, las excepciones y las decisiones con consecuencias.
La entrega tradicional se organiza alrededor de actividades humanas: redactar una tarea, implementar el cambio, revisar la solicitud de incorporación y publicar. Un equipo con agentes funciona mejor con paquetes de trabajo controlados. Cada paquete combina un resultado, el contexto relevante, restricciones, pruebas de aceptación, permisos y una vía de escalado.
La diferencia importa. Una instrucción vaga como «mejora el proceso de pago» obliga al agente a inventar la intención del producto. Un buen paquete especifica qué recorrido falla, qué servicios se pueden modificar, qué límites de seguridad y latencia se aplican, cómo se medirá el éxito y qué decisiones necesitan aprobación.
El paquete se convierte en el acuerdo entre el criterio humano y la ejecución automática. Los modelos mejores ayudan, pero la calidad de ese acuerdo suele determinar si el resultado está listo para producción o solo parece convincente.
Siete funciones en un ciclo de entrega con agentes
Son funciones de decisión, no necesariamente siete puestos. En un equipo pequeño, una persona puede asumir varias. En una fábrica de software mayor, cada función de agente puede ser un grupo coordinado de especialistas.
1. Responsable de producto: define el resultado
Describe el resultado para el usuario o el negocio, el riesgo aceptable y las pruebas necesarias para darlo por válido. Conviene evitar imponer la implementación técnica, salvo que sea una restricción.
2. Arquitectura: define los límites
Traduce la intención en límites del sistema: servicios, interfaces, propiedad de datos, requisitos no funcionales y decisiones que un agente no puede tomar por sí solo. La arquitectura deja de ser solo un dibujo del estado final y pasa a delimitar un espacio de decisión seguro.
3. Ingeniería de contexto: prepara el entorno
Reúne el estado del repositorio, las reglas de diseño, las decisiones previas, los accesos, los datos de prueba y el conocimiento operativo. Así, cada ejecución no tiene que redescubrir la organización por ensayo y error.
4. Agente planificador: descompone el trabajo
Propone tareas, dependencias, supuestos y puntos de control. El plan se puede revisar antes de iniciar una ejecución costosa o de gran impacto. Si existe una incertidumbre importante, pregunta a una persona en vez de ocultar el supuesto en el código generado.
5. Agentes constructores: producen los artefactos
Implementan código, pruebas, migraciones, documentación y configuración en espacios aislados. Pueden trabajar en paralelo cuando sus contratos están claros y sus cambios se pueden integrar con seguridad.
6. Agentes revisores: cuestionan el resultado
Conviene separar a quienes revisan de quienes construyen. Revisan diferencias, prueban casos límite, buscan problemas de seguridad o políticas y comprueban los criterios de aceptación. Su trabajo no es asentir, sino encontrar motivos fundados para no publicar el cambio.
7. Revisión humana y operación de plataforma: deciden y observan
Una persona evalúa las pruebas en el punto de control adecuado y se centra en ambigüedades, compensaciones e impacto, en vez de releer cada línea generada. Después, operaciones publica dentro de las políticas, vigila producción y utiliza lo aprendido en el siguiente paquete.
Cómo se encadenan las funciones
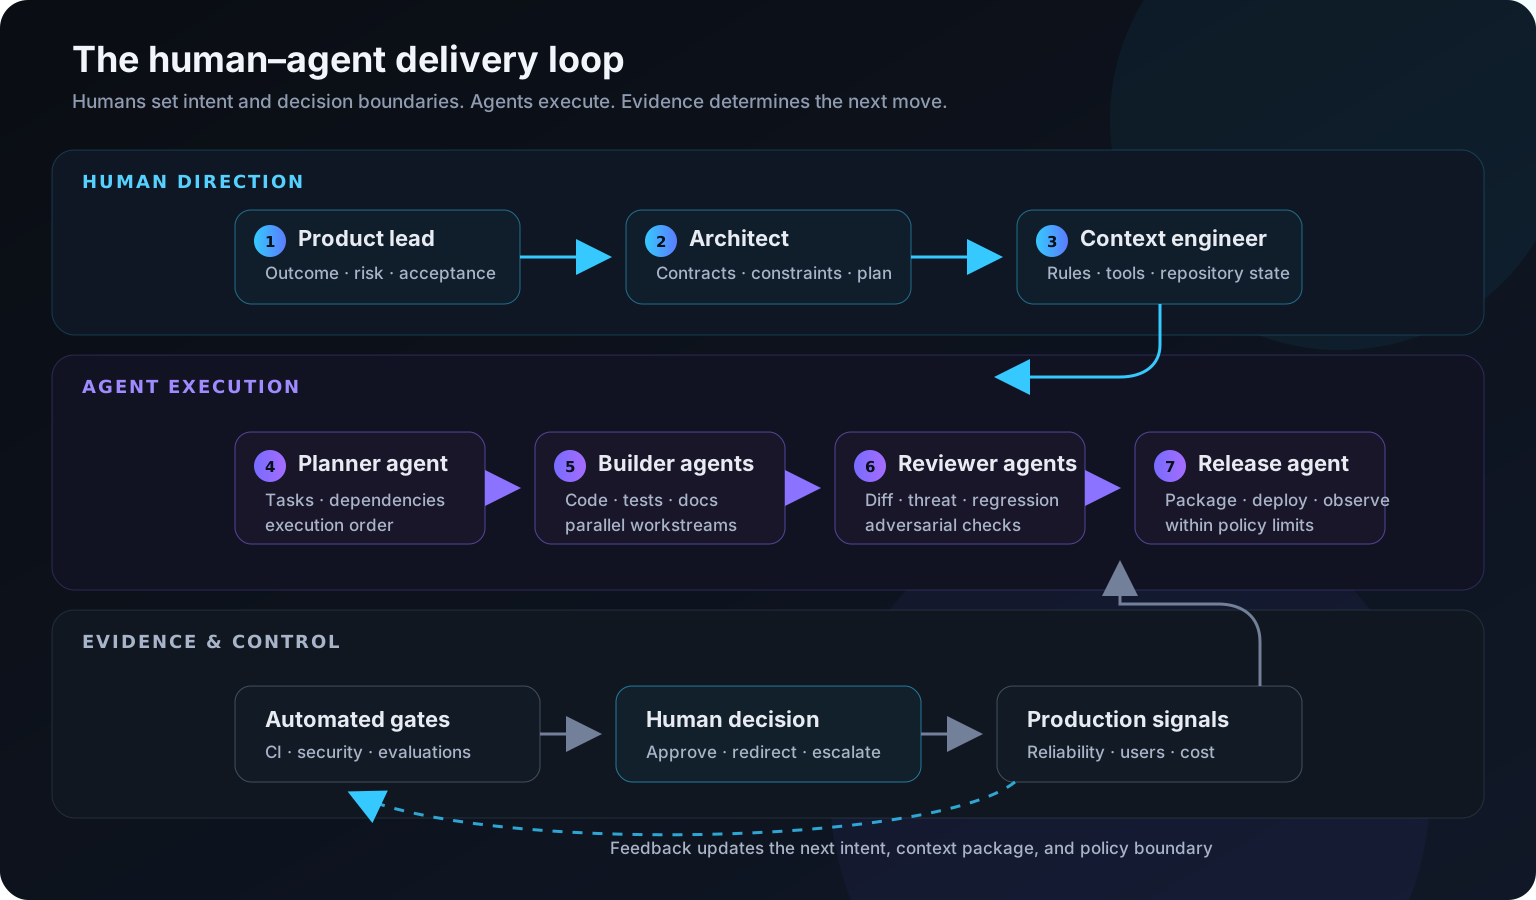
La secuencia no es una cadena de montaje de una sola dirección. La orientación humana pasa a la ejecución de los agentes; controles automáticos y personas evalúan el resultado; las evidencias de producción alimentan el siguiente ciclo de planificación. Un equipo maduro hace explícita cada transición.
Las personas definen el espacio de decisión, los agentes ejecutan dentro de esos límites y las pruebas determinan si el trabajo avanza, vuelve atrás o se escala.
No hace falta pedir aprobación después de cada acción de un agente. Eso conservaría el coste del proceso anterior y añadiría la sobrecarga de automatización. Los controles deben aparecer cuando cambia el riesgo: antes de otorgar privilegios, de una migración irreversible, de exponer algo a clientes o cuando las pruebas superan un umbral acordado.
Qué pueden asumir los agentes y qué deben asumir las personas
La división más clara depende de si una acción se puede revertir, observar y de sus consecuencias, no de que parezca una tarea técnica.
Los agentes pueden asumir
Planificar dentro de una arquitectura y un alcance aprobados
Implementar tareas rutinarias en ramas o espacios aislados
Generar pruebas, hacer análisis estático y actualizar documentación
Refactorizar cambios de bajo riesgo con buena cobertura de regresión
Hacer despliegues reversibles dentro de los límites definidos
Monitorizar, reunir evidencias y recomendar reversiones
Las personas deben asumir
La intención del producto y las prioridades
Decisiones de arquitectura con consecuencias a largo plazo
Cambios en los límites de seguridad, privacidad o cumplimiento
Requisitos ambiguos y necesidades de partes interesadas en conflicto
Operaciones irreversibles con datos y lanzamientos de gran impacto
Excepciones cuando las políticas y las pruebas no coinciden
La autonomía escala cuando la aprobación se basa en pruebas visibles. Las personas atienden las excepciones y las decisiones importantes; los controles repetibles funcionan de forma continua.
Una regla útil: si cuesta revertir una decisión, es difícil observarla o puede cruzar un límite de confianza, una persona debe responder de ella.
Cómo rediseñar los flujos de trabajo
Añadir agentes a la cola de tareas existente no cambia el modelo operativo. A menudo genera más solicitudes de cambios, más presión de revisión y más trabajo mal definido. Hay que organizar el flujo alrededor del contexto y las pruebas.
Empieza con un flujo acotado. Elige un cambio repetible, bien probado, con permisos limitados y una vía clara de reversión.
Define el contrato del paquete. Estandariza cómo se aportan objetivos, restricciones, contexto, criterios de aceptación, herramientas y reglas de escalado.
Separa a quien construye de quien evalúa. Combina revisores independientes y controles deterministas; no preguntes al mismo agente si su trabajo está bien.
Aprueba en los límites de riesgo. Reserva decisiones humanas para los puntos donde crecen la autoridad, el impacto, la sensibilidad de los datos o la incertidumbre.
Incluye producción en el ciclo. Lleva incidentes, señales de soporte, cambios de rendimiento y reversiones a la planificación.
Amplía la autonomía cuando mejoren las pruebas. Aumenta permisos y alcance cuando el flujo demuestre fiabilidad, no porque una demo resulte impresionante.
Cómo medir el modelo operativo
Las líneas de código generado y el uso de agentes miden actividad, no resultados. Conviene observar el sistema completo:
Flujo: tiempo desde la aceptación de una necesidad hasta producción, tiempo en cola y trabajo completado sin traspasos evitables.
Calidad: tasa de fallos por cambio, defectos detectados por clientes, frecuencia de reversiones y pruebas de aceptación superadas.
Control: cobertura de controles automáticos, tiempo de revisión humana, escalados, incumplimientos de políticas e intentos de acciones no autorizadas.
Economía: coste total de ingeniería y computación por cambio aceptado, incluyendo revisión y retrabajo.
Aprendizaje: frecuencia con la que las pruebas en producción mejoran una regla, un test, un paquete de contexto o una decisión de arquitectura.
El mejor modelo no maximiza la actividad autónoma: maximiza los cambios útiles, limita los fallos y mantiene las decisiones bajo responsabilidad clara.
Conclusión
Los equipos de ingeniería no dejan de ser relevantes cuando los agentes ganan capacidad. Su trabajo se desplaza hacia decisiones que las máquinas no deberían asumir: qué importa, qué debe proteger el sistema, qué compromisos son aceptables y cuándo las pruebas bastan para continuar.
Las empresas que más se beneficien no serán necesariamente las que desplieguen más agentes. Serán las que construyan un sistema de trabajo claro: contexto mantenido, autoridad acotada, pruebas visibles y personas responsables cuando la respuesta no sea obvia.
Artículo
23 abr 2026
LangChain frente a LangGraph
Ingeniería de IALangChainLangGraph7 min de lectura
Publicado el 23 abr 2026 · Por Adam C, Core Dynamics
Cuando un equipo nos pregunta si debería usar LangChain o LangGraph, la cuestión suele ser cuánto control necesita. ¿Basta con una secuencia sencilla de llamadas al modelo y herramientas, o hace falta un grafo con estado, ciclos, bifurcaciones y recuperación?
LangChain funciona muy bien cuando el flujo es principalmente lineal y se puede expresar como una cadena de pasos. LangGraph resulta útil cuando el sistema necesita agentes de varios pasos con estado y transiciones explícitas.
No es necesario elegir uno como si fueran alternativas incompatibles. Muchas arquitecturas de producción usan ambos: LangChain aporta componentes reutilizables y abstracciones para herramientas; LangGraph coordina su ejecución en el tiempo.
En resumen: utiliza LangChain para construir capacidades y LangGraph para coordinar comportamientos complejos de agentes mediante transiciones de estado explícitas.
La diferencia clave es el modelo de ejecución. LangChain se centra en cadenas y componentes combinables; LangGraph, en máquinas de estado representadas como grafos.
En un flujo con LangChain, la ejecución suele avanzar paso a paso. En uno con LangGraph, puede repetir, bifurcarse, pausarse y reanudarse según el estado y el resultado de cada nodo.
Esto importa para la fiabilidad. Si necesitas puntos de control deterministas, reintentos por nodo, aprobaciones humanas o sesiones de agente de larga duración, la orquestación con grafos suele ofrecer un control más claro.
Cuándo conviene LangChain
Montar capacidades con rapidez
LangChain permite combinar rápidamente instrucciones, sistemas de recuperación, herramientas y analizadores de salida en un flujo útil. Sus integraciones y abstracciones ayudan a pasar pronto del prototipo a herramientas internas funcionales.
Flujos combinables y legibles
Para muchos procesos de negocio basta con una cadena clara: clasificar la intención, recuperar contexto, llamar al modelo y dar formato a la respuesta. LangChain facilita entenderla y ampliarla.
Una buena opción para pasar del MVP a la primera versión
Si el sistema no necesita conservar el estado de un grafo, LangChain suele reducir la complejidad y acelerar la entrega.
Cuándo conviene LangGraph
Orquestación de agentes con estado
LangGraph está pensado para agentes que deben seguir su estado durante varios pasos y elegir transiciones de forma dinámica: ciclos de reintento, alternativas entre herramientas y rutas condicionales tras una validación.
Ejecución controlable y persistente
Cuando importa más la corrección que la velocidad bruta, los nodos y las conexiones explícitas facilitan inspeccionar el comportamiento y localizar fallos en transiciones concretas.
Flujos supervisados o con varios actores
Los patrones de planificador y ejecutor, los traspasos y las aprobaciones humanas durante la ejecución encajan de forma natural en esta arquitectura.
Regla práctica: cuanto más se parezca el sistema a un motor de flujos de trabajo, más probable es que LangGraph sea la capa de control adecuada.
Diagramas de los frameworks
Dos referencias visuales para comparar la forma de cada arquitectura:
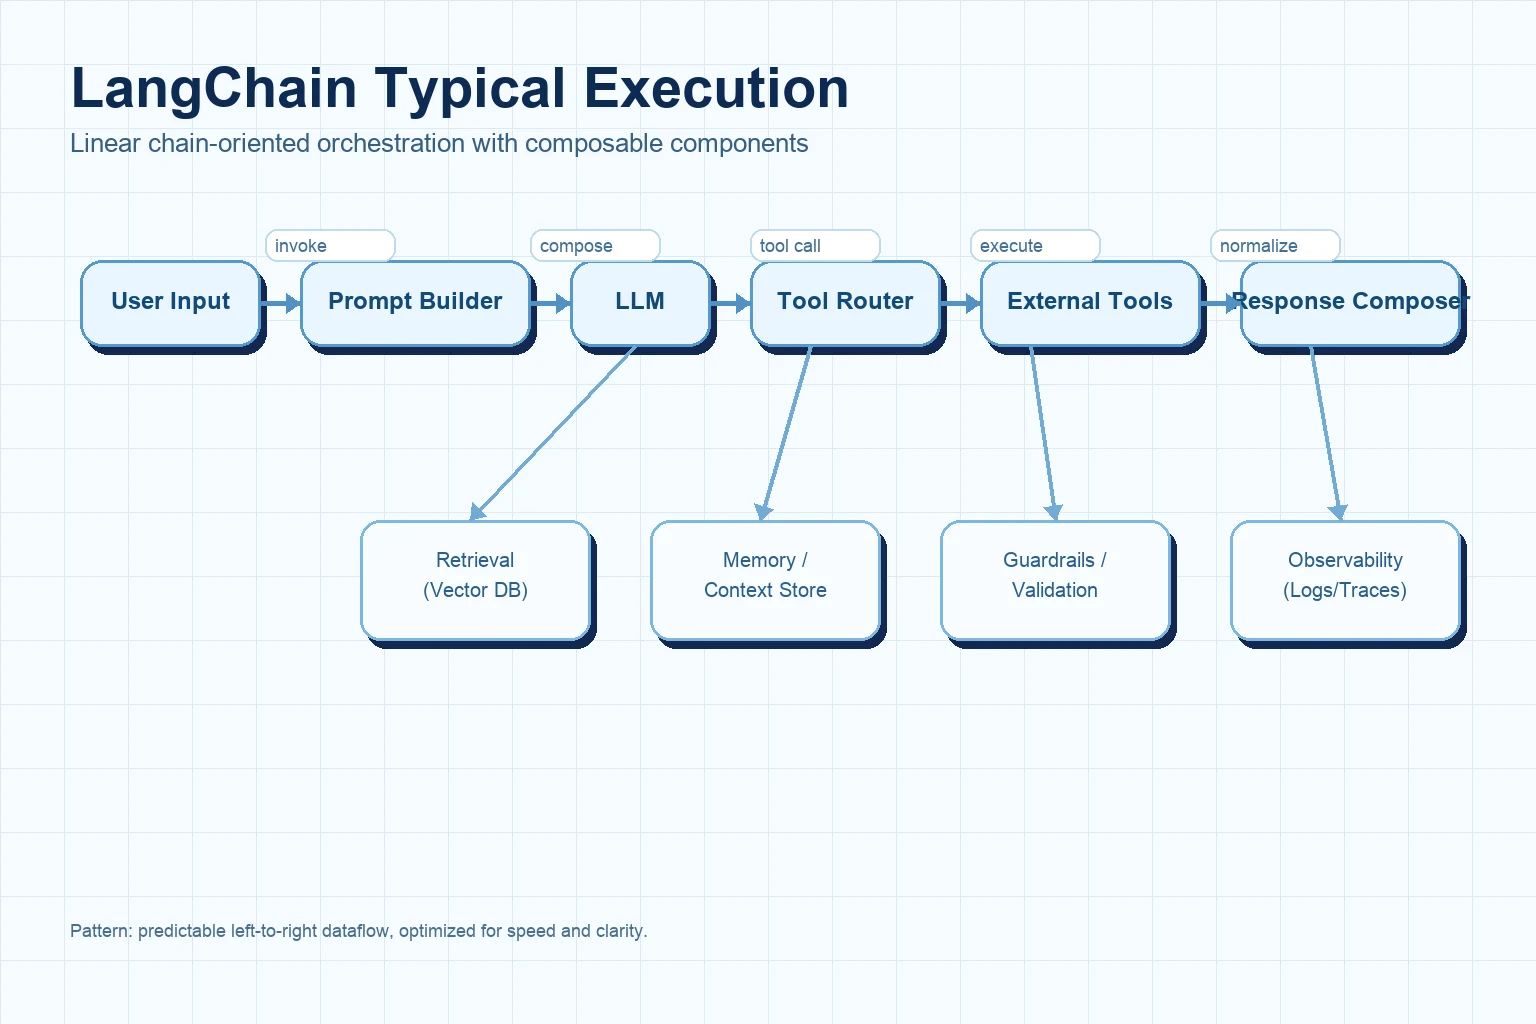
Flujo de LangChain, orientado a cadenas
LangChain suele encajar en flujos que parecen una canalización dirigida: componer instrucciones y herramientas, llamar al modelo, ejecutar herramientas y devolver el resultado.
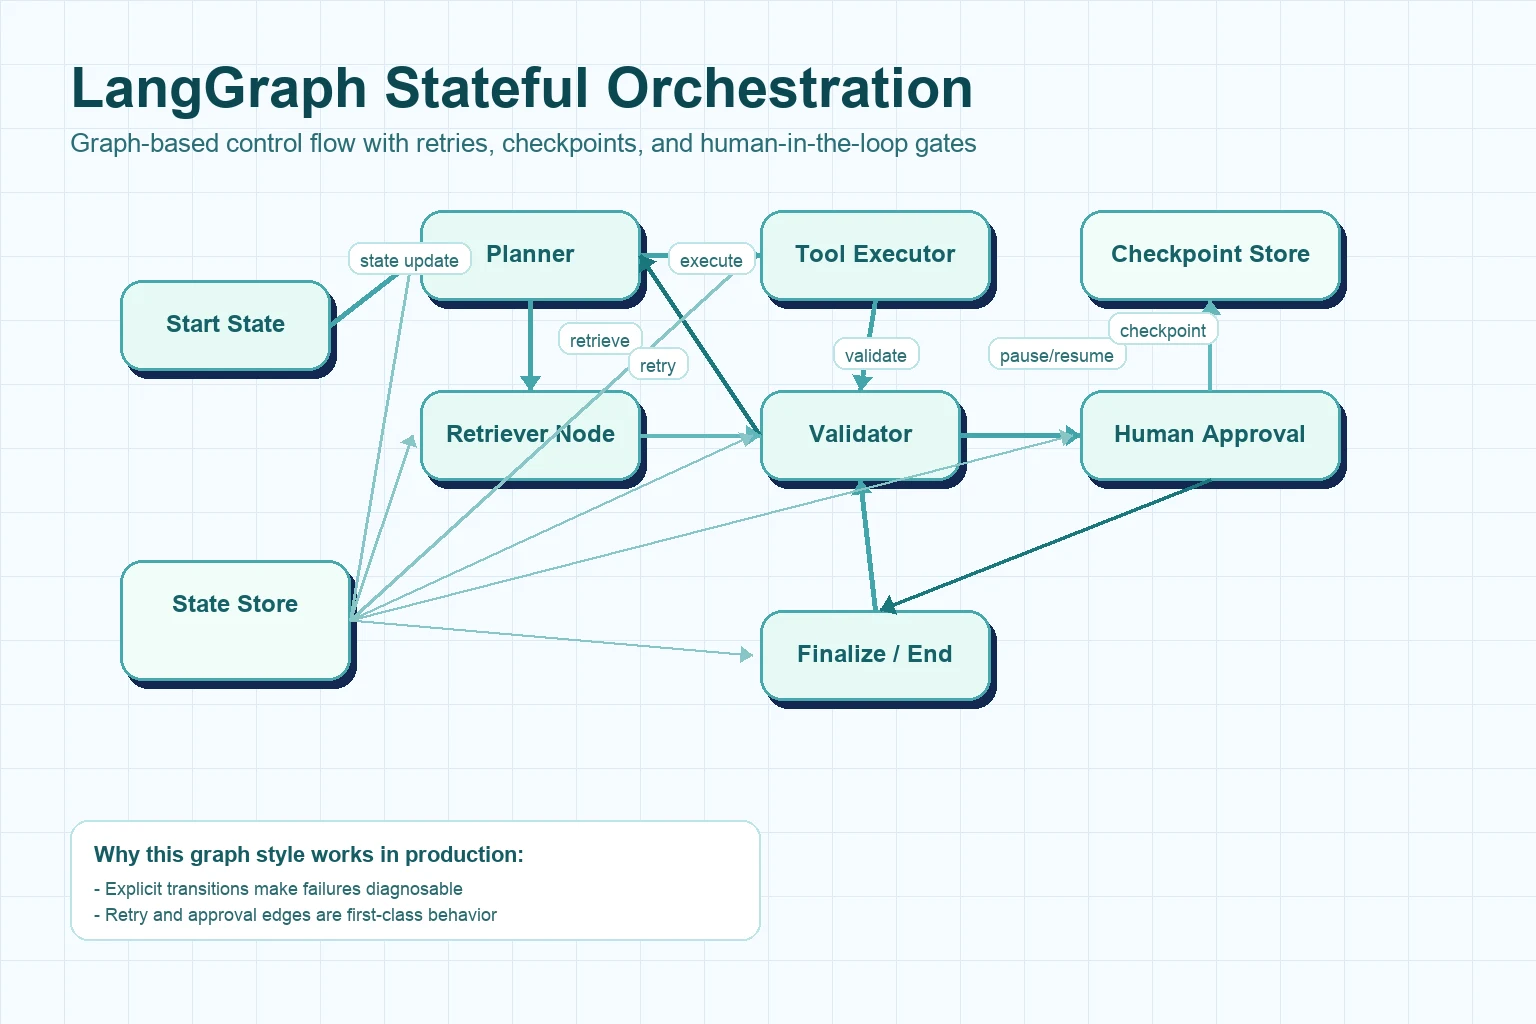
Flujo de LangGraph, con orquestación de estado
LangGraph representa la ejecución como transiciones explícitas de estado, de modo que los ciclos, reintentos, puntos de control y traspasos humanos forman parte de la arquitectura.
Guía para elegir
Elige primero LangChain si el flujo es principalmente lineal y priorizas entregar rápido con abstracciones claras.
Elige primero LangGraph si necesitas bifurcaciones, reintentos, estado persistente y control explícito de la orquestación.
Combina ambos si quieres componentes LangChain dentro de una ejecución controlada por LangGraph para ganar fiabilidad en producción.
La decisión depende menos de la popularidad que de cómo se gestionan los fallos. Si son sencillos, las cadenas suelen bastar. Si forman parte del comportamiento del producto, la orquestación con grafos suele compensar pronto.
Conclusión
LangChain y LangGraph se complementan. Las arquitecturas de producción más claras suelen tratarlos como capas: LangChain aporta capacidades y LangGraph controla la ejecución.
Si tu equipo debe decidirlo ahora, dibuja primero el comportamiento real en ejecución. Cuenta bifurcaciones, reintentos, aprobaciones y cambios de estado. Ese mapa suele indicar qué framework debe ocupar el centro.
Artículo
22 mar 2026
Fundamentos de la arquitectura de servidores MCP
ArquitecturaMCPSistemas de agentes8 min de lectura
Publicado el 22 mar 2026 · Por Adam C, Core Dynamics
En Core Dynamics, casi ningún cliente empieza diciendo «necesitamos MCP». Suele plantear algo más directo: «Queremos que el asistente consulte nuestros sistemas, quizá escriba más adelante, y necesitamos saber que no romperá nada». Ese es el encargo real. Cuando los equipos llegan a esta conversación, normalmente ya han superado la fase de demos vistosas. Buscan control.
En reuniones de inicio, las primeras notas en la pizarra no hablaban de velocidad ni de modelos. Eran preguntas sencillas: ¿quién puede llamar a qué?, ¿qué se registra?, ¿qué pasa si falla un sistema conectado? Por ahí empieza una buena arquitectura MCP.
Model Context Protocol, o MCP, ofrece a los clientes de IA una forma estándar de descubrir herramientas, invocarlas e intercambiar contexto estructurado con sistemas externos. En términos sencillos, un servidor MCP es la capa controlada entre un cliente de IA y los sistemas que utiliza una empresa: API, bases de datos, flujos de trabajo, documentos y servicios internos.
El patrón se repite: los clientes quieren permisos de lectura antes que escritura, una lista corta de herramientas fiables antes que un catálogo enorme y trazabilidad para cada llamada. El reto técnico es ofrecer capacidades útiles sin exponer el caos interno. El servidor MCP es la puerta de entrada, la barrera de seguridad y el registro de lo ocurrido.
Un servidor MCP se sitúa entre un cliente de IA y uno o varios sistemas internos. El cliente puede ser un asistente de escritorio, un agente de navegador, una consola interna de operaciones u otro servicio. El servidor publica herramientas y esquemas; el cliente las descubre, envía llamadas estructuradas y recibe respuestas estructuradas.
Por ejemplo, si un chatbot necesita consultar una factura, no debería conectarse directamente a la base de datos contable. Debería llamar a una herramienta MCP como get_invoice(invoice_id). El servidor valida la entrada, aplica las reglas de acceso, consulta el sistema correspondiente y devuelve solo los datos que el cliente puede ver.
En pocas palabras: el servidor MCP traduce y controla la interacción entre una IA y el software que necesita utilizar. Hace que esa interacción sea coherente y más segura.
Capas principales de la arquitectura
Un servidor MCP sólido suele separar cinco capas. En los primeros prototipos se pueden mezclar, pero cuando llegan usuarios reales la separación facilita mantenerlo:
1. Capa de transporte
Es la puerta de entrada. Gestiona peticiones MCP, flujos, tipos de contenido y formato de las respuestas. No debería contener la lógica de negocio; traduce el tráfico del protocolo a llamadas internas.
2. Registro de herramientas y esquemas
Define qué herramientas existen, cómo se llaman, qué argumentos aceptan y qué formato devuelven. Los esquemas acotados y claros ayudan a que los modelos se comporten mejor que con contratos ambiguos.
3. Capa de orquestación
Gestiona el enrutamiento, los reintentos, las comprobaciones de políticas y la composición entre servicios. Una herramienta puede consultar un sistema; otra puede combinar tres fuentes. Aquí suele concentrarse gran parte del trabajo de diseño.
4. Adaptadores de integración
Conectan el servidor con bases de datos, API de CRM, almacenamiento de archivos, buscadores y servicios internos. Separarlos evita mezclar el protocolo con el código específico de cada proveedor.
5. Observabilidad y controles de políticas
Un servidor MCP en producción necesita registros, trazas, gestión de errores, límites de uso y controles de autenticación. El equipo debe poder responder rápido quién hizo una llamada, qué datos envió, qué sistema se consultó y qué resultado volvió.
Idea práctica: muchos prototipos MCP se quedan en los esquemas y nombres de herramientas. Eso funciona hasta que aparece una entrada incorrecta, un fallo de permisos o un tiempo de espera agotado.
Qué ocurre durante una petición
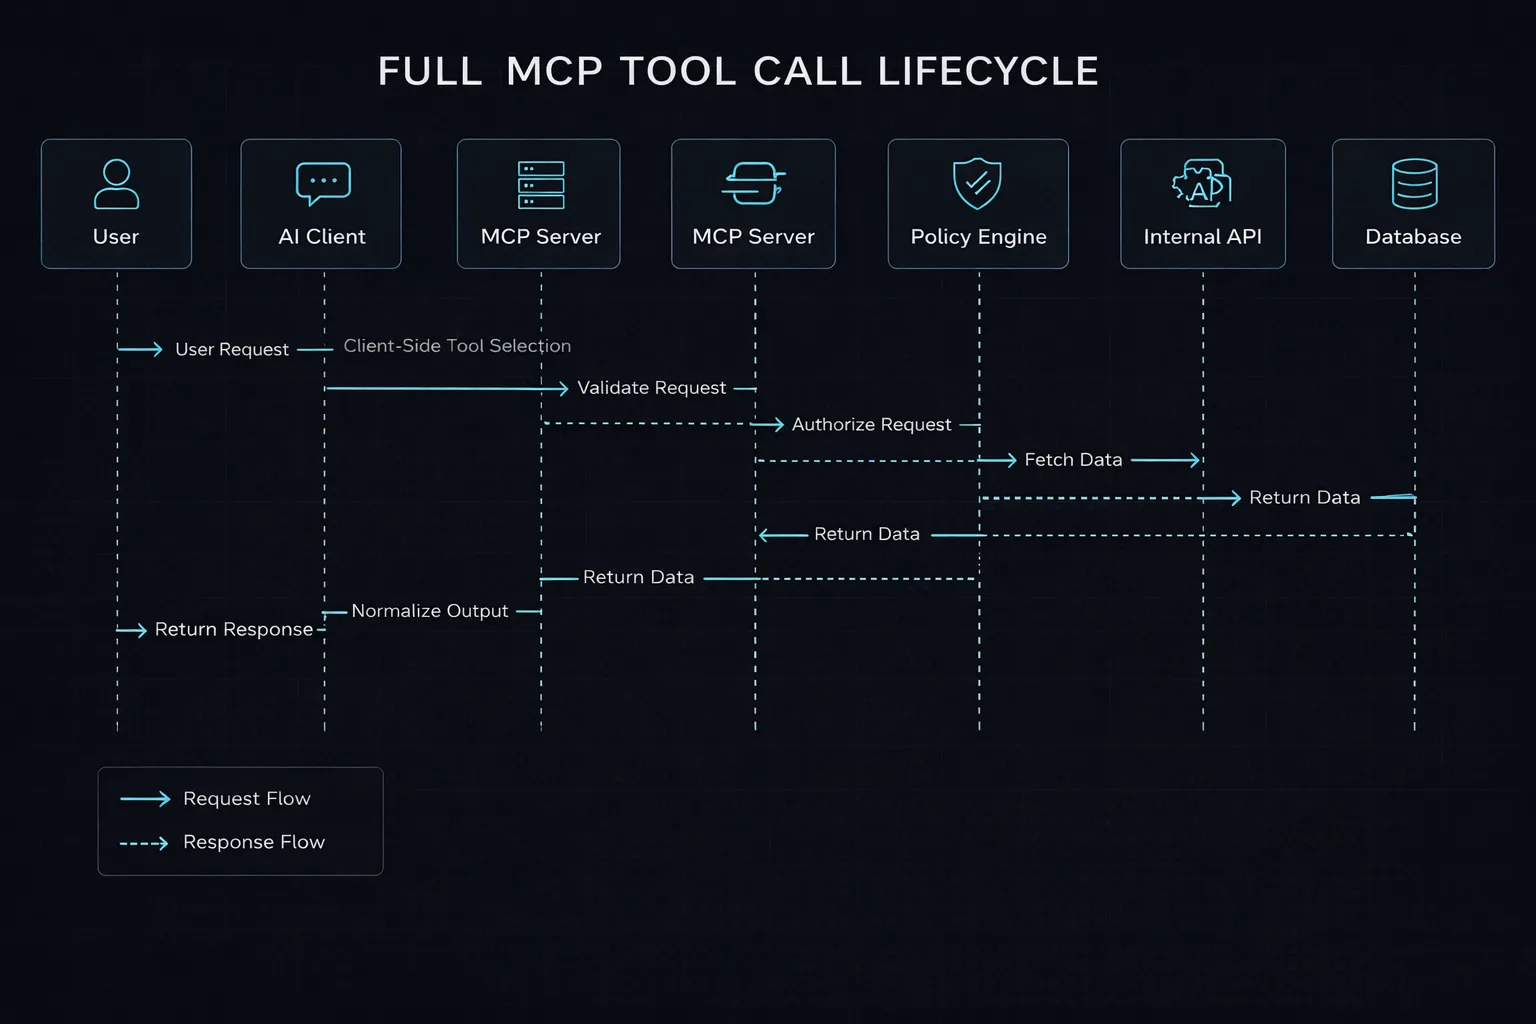
La forma más sencilla de entender MCP es seguir una petición de principio a fin:
Descubrimiento: el cliente conoce las herramientas disponibles y el esquema de entrada que espera cada una.
Selección: el modelo determina si necesita una herramienta para la tarea actual.
Invocación: el cliente envía una llamada estructurada al servidor MCP.
Validación: el servidor comprueba campos obligatorios, tipos, límites de tamaño y políticas.
Ejecución: la orquestación llama al adaptador o servicio correspondiente.
Normalización: el resultado del sistema se transforma en una respuesta predecible y adecuada para el modelo.
Devolución: el cliente recibe el resultado y lo utiliza en su siguiente paso.
Un servidor MCP no es solo una envoltura de API. Convierte una decisión imprecisa del modelo en una acción controlada y determinista. Si esta capa falla, el conjunto se vuelve impredecible.
Por eso, decir «la IA tiene acceso a nuestros sistemas» es una forma equivocada de verlo. Lo importante es que solo acceda mediante un conjunto pequeño de operaciones definidas por el servidor, con contratos estrictos y un recorrido trazable.
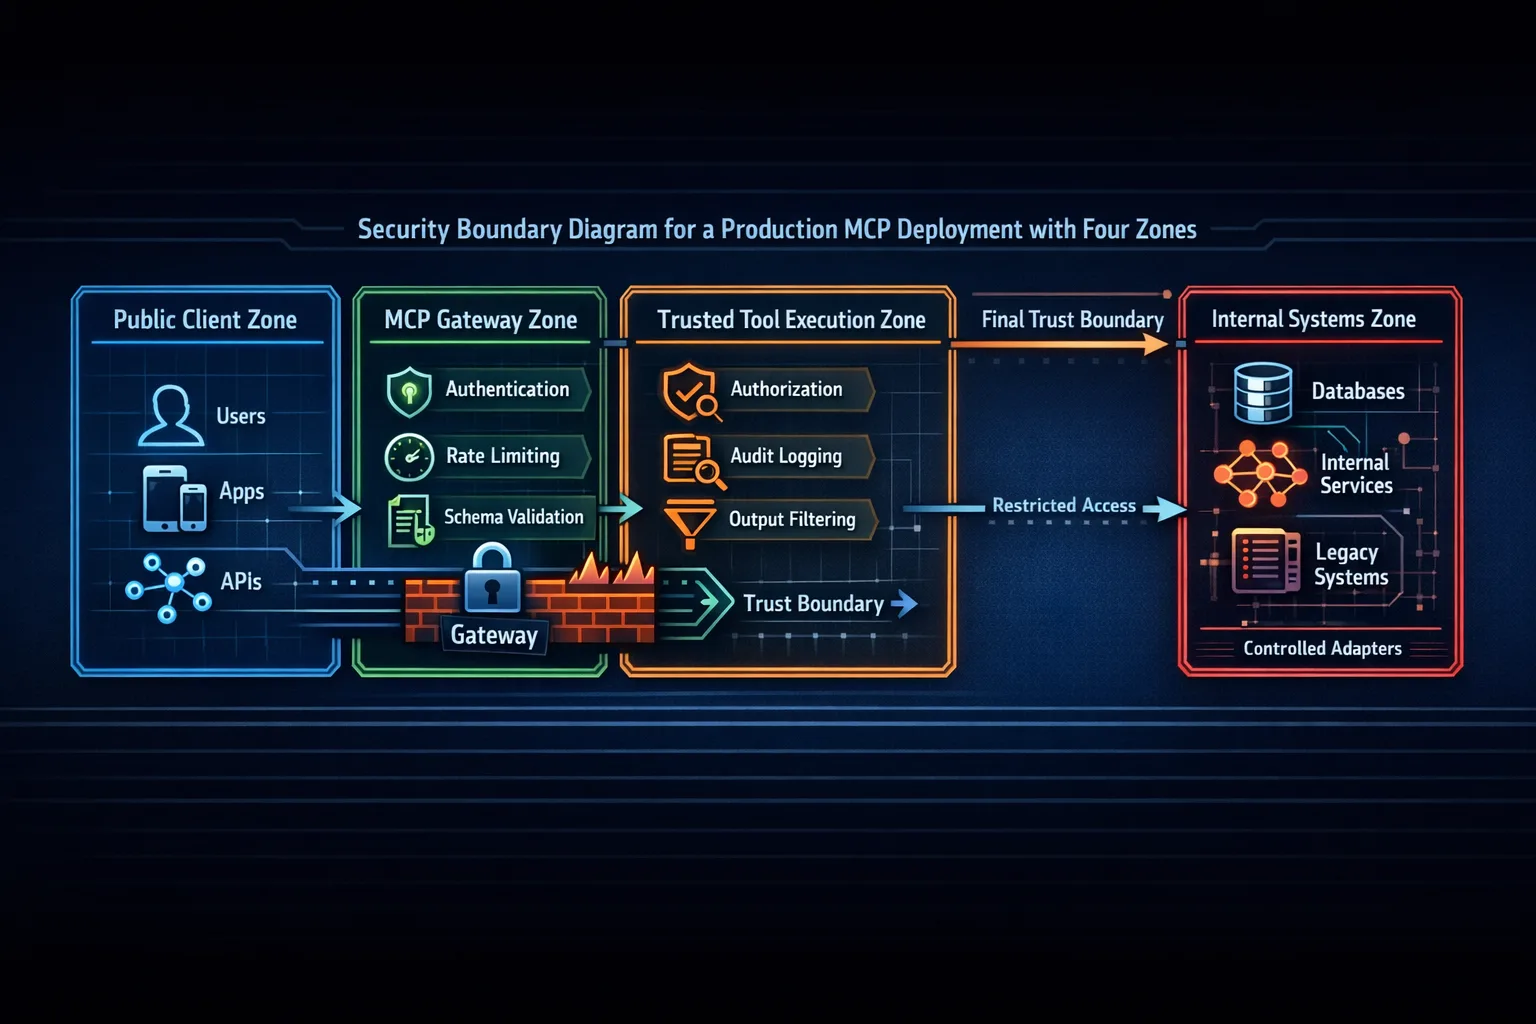
Seguridad y límites de confianza
Muchos errores de arquitectura MCP son errores en los límites de confianza. No basta con confiar en que el modelo se comporte bien porque las descripciones de las herramientas sean claras. El servidor debe asumir que cualquier llamada puede estar mal formada, ser demasiado amplia, repetirse o proceder de un cliente sin permisos suficientes.
Como mínimo, debe aplicar autenticación, autorización, validación de entradas, filtrado de salidas y límites de uso. Las herramientas sensibles necesitan barreras más estrictas. Una consulta de solo lectura no debería compartir el mismo nivel de confianza que una acción que modifica registros, inicia pagos o crea incidencias.
También es frecuente devolver más datos de los necesarios por comodidad. Si una herramienta de facturación solo necesita el estado y la fecha de vencimiento, no debería devolver además el historial de pagos, notas internas e identificadores de cuenta sin una razón clara.
En pocas palabras: el riesgo no es que la IA se vuelva maliciosa de repente. El riesgo es que un servidor mal diseñado le conceda demasiada autoridad o datos para la tarea.
Patrones importantes en producción
Cuando un prototipo empieza a tratar con usuarios reales, tres patrones suelen marcar la diferencia:
Herramientas sencillas, políticas estrictas
Mantén interfaces fáciles de invocar, pero aplica controles profundos en el servidor: validación, permisos, idempotencia y salvaguardas específicas para cada sistema.
Contratos estables y adaptadores sustituibles
El contrato visible para el cliente debería mantenerse estable aunque cambie el sistema interno. Así puedes sustituir un proveedor de CRM o cambiar una consulta SQL por un servicio interno sin volver a formar a usuarios ni rehacer todo el flujo.
Trazas para todo lo que influye en el resultado
Los incidentes rara vez empiezan en un único punto. El cliente puede elegir una herramienta, enviar poco contexto, el servidor reintentar una llamada y el resultado volver incompleto. Sin trazas y registros estructurados, encontrar la causa es cuestión de adivinar.
Un buen servidor MCP debería resultar aburrido en un mal día. Es un cumplido: significa que el sistema sigue siendo predecible cuando algo falla.
Diagramas de arquitectura
Para explicar proyectos MCP solemos mostrar tres perspectivas: la estructura, el recorrido de una petición y los límites de confianza. Este orden ayuda a que los equipos técnicos y de negocio compartan una misma visión.
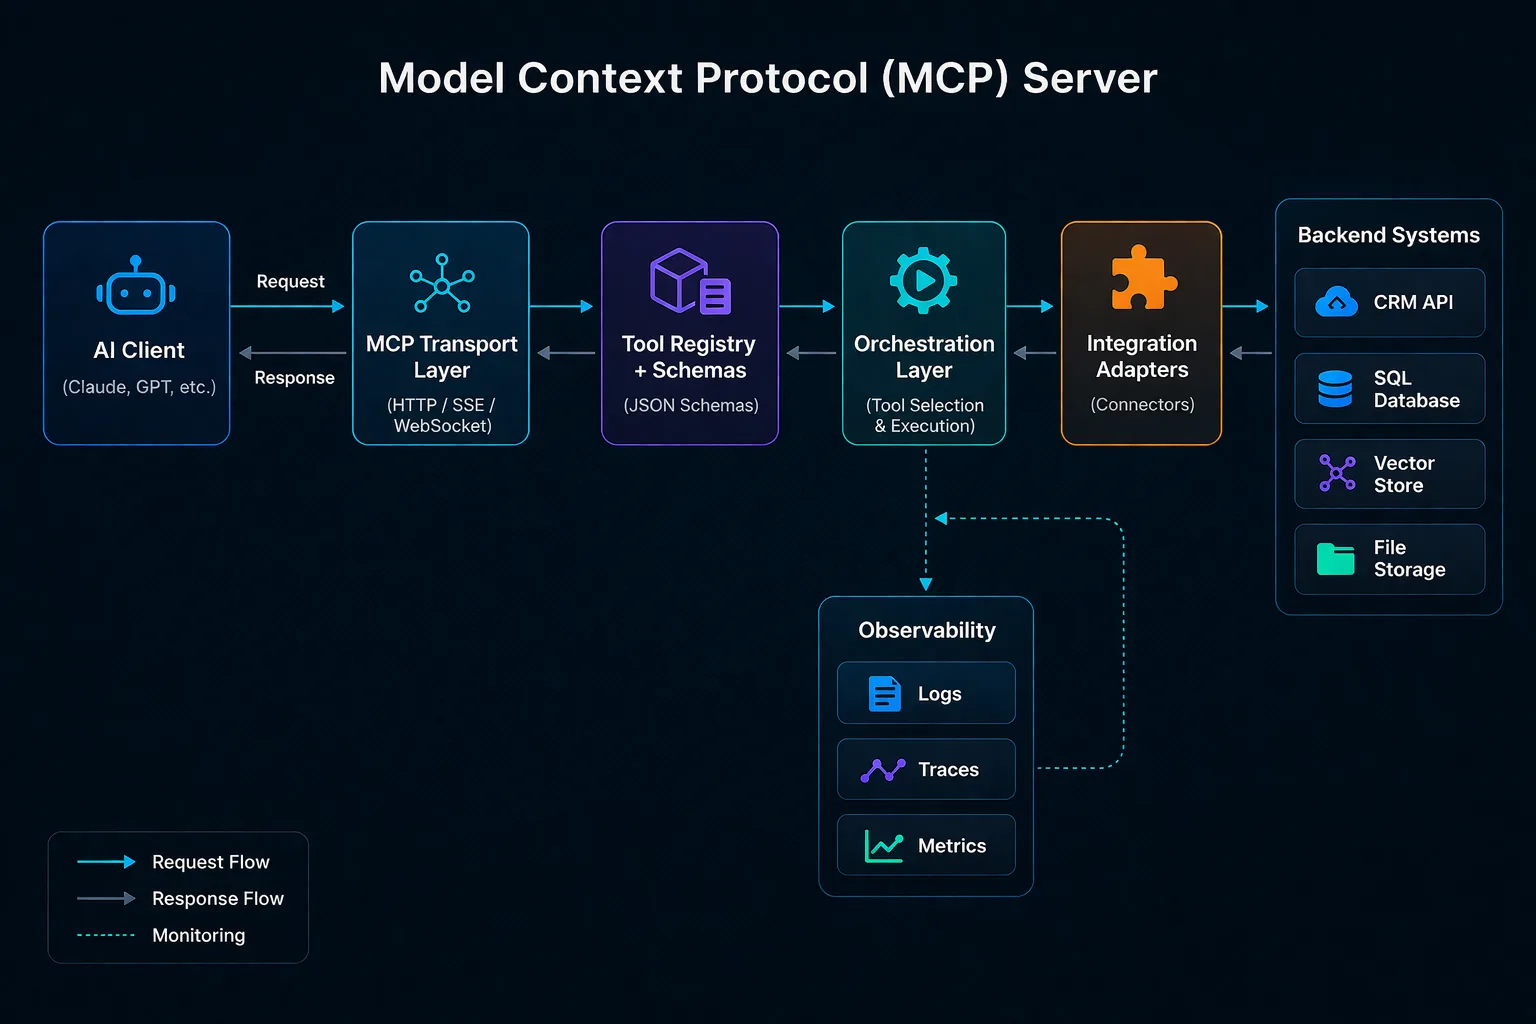
Arquitectura MCP de alto nivel
El cliente se conecta al transporte del protocolo, que resuelve herramientas mediante esquemas, ejecuta la orquestación y accede a los sistemas a través de adaptadores. Los registros, trazas y métricas deben estar presentes desde el inicio.
Ciclo de una llamada a herramienta
Una llamada controlada incluye interpretación, selección, validación, políticas, ejecución, normalización y respuesta; no es un salto directo al sistema interno.
Límites de confianza y zonas de seguridad
La confianza debe estrecharse a medida que la petición avanza hacia dentro. Autenticación, validación, autorización, registros y filtrado de salidas forman parte de la arquitectura.
Conclusión
MCP obliga a definir con claridad los límites de las herramientas, los esquemas, los permisos y los caminos de ejecución. Eso convierte un sistema de agentes de una demo en algo que un equipo puede utilizar con confianza.
Cuando el primer prototipo se conecta a sistemas reales, los clientes suelen pedir menos sorpresas, límites más estrictos, mejores registros y herramientas que sigan funcionando cuando termina la demo. Rara vez necesitan añadir más herramientas; normalmente necesitan que las correctas se comporten bien.
Si hubiera que resumirlo en una regla: mantén pequeña la superficie de herramientas, aplica políticas estrictas y conserva registros legibles. Así MCP sigue siendo útil incluso cuando algo falla.